近日,南开大学软件学院智能运维实验室的论文《CoreCapture: Anomaly-Aware System Trace Sampling for Resource-Constrained Mobile Devices》被计算机系统领域CCF A类国际会议——The 2026 ACM SIGOPS Annual Technical Conference(ATC 2026)录用。
论文简介
论文标题:CoreCapture: Anomaly-Aware System Trace Sampling for Resource-Constrained Mobile Devices
论文链接:https://nkcs.iops.ai/publications/
作者:孙永谦、王筱天、隋轶丞*、冯金涛、张越、张圣林、郑博文、李强、梁伟、裴丹
作者单位:南开大学、华为、清华大学
Part.1 摘要
生产环境中移动设备的性能异常诊断依赖系统跟踪数据。系统跟踪数据(System Trace)记录了内核、系统服务和应用的运行过程,然而,单次转储的数据量超过100 MB,且所有诊断组件共用每日上传额度,导致每天能够保存并上传的系统跟踪数据数量有限。额度耗尽后出现的异常可能永久失去诊断证据。为此,本研究提出端侧异常感知系统跟踪采样框架CoreCapture:利用双流系统跟踪异常检测模型(DS-TraceNet)分别学习操作语义和执行时序,再通过时空异常事件保留机制(STA-ER),将异常跟踪序列扩展为完整的交互事件窗口,并剔除无关线程。基于真实生产数据的评估与内部测试设备的部署实测表明,CoreCapture在每次告警触发的系统数据转储处理期间,仅增加约4%-5%的CPU开销和13-15 MB的内存开销,便可剔除约70%的冗余数据,同时异常事件召回率达到约95%。
Part.2背景与挑战
移动设备发生界面卡顿或触控延迟时,工程师需要借助系统调用链还原内核、系统服务和应用的运行过程。然而,传统完整转储包含大量与故障无关的平稳数据,少数几次转储便可能耗尽系统落盘和云端上传设置的额度,数据价值密度低,但如果只截取短片段则可能遗漏异常前后的因果上下文或造成采集事件不完整。因此,本研究将这一问题形式化为“异常感知调用链采样”(Anomaly-Aware Trace Sampling,AATS):一方面尽量覆盖真实异常,另一方面降低持久化数据比例,并确保保留片段具有诊断上下文。
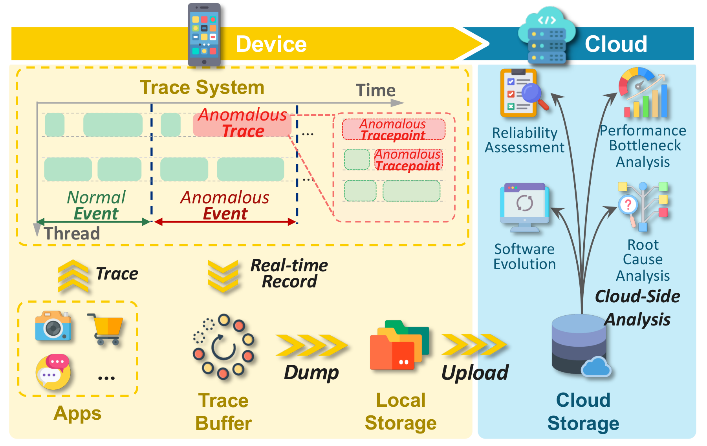
图1:系统调用链的完整端云链路
挑战一:在资源约束下识别不同类型的异常。通过考察发现,生产调用链中的异常可表现为单次操作耗时过长、相邻操作间隔异常,以及同样的耗时对不同操作类型具有不同含义。因此,仅依据时间数值或操作名称都难以可靠判断异常。模型需要具有平衡语义与时间特征,准确识别异常表征的能力。
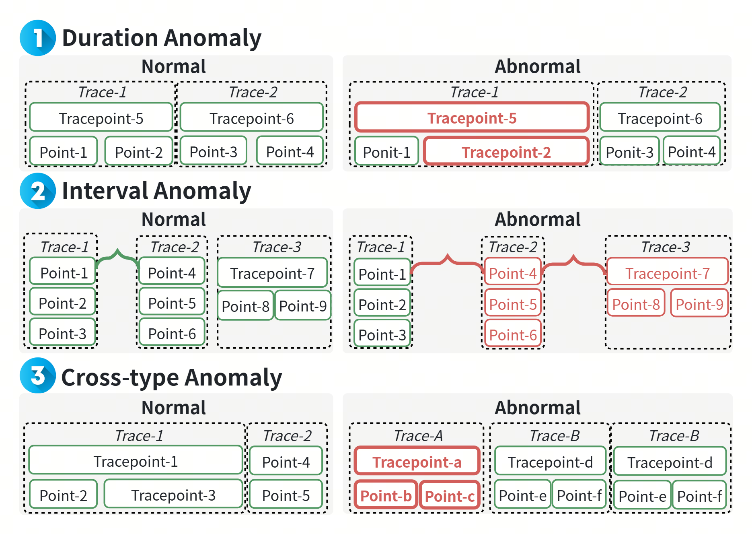
图2:三种典型异常事件模式
挑战二:保留异常前后的诊断上下文,同时控制数据量。工程师定位根因时,需要查看异常发生前的触发过程、发生后的影响,以及相关线程间的执行关系。只保存被判为异常的孤立调用锚点,可能切断完整的因果链。采样因此需要在时间维度覆盖足够完整的事件过程,在空间维度筛选关键线程,兼顾诊断所需的上下文与数据压缩效果。
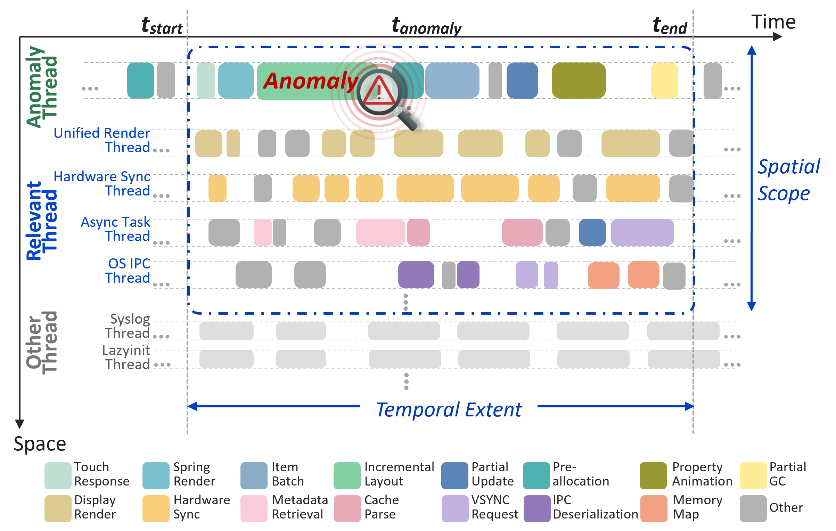
图3:以异常为中心的系统调用链时空裁剪与保留示例
Part.3核心方法与系统架构
CoreCapture采用“离线训练、端侧推理、选择性留存”的流程,先对调用点名称进行参数过滤,提取操作序列、执行持续时间和相邻调用间隔;异常检测模型分别学习语义和时间信息,双支路融合后给出异常分数。在采样阶段,系统以检出的异常为锚点,扩展至完整用户交互事件,并按照关键线程知识库筛除无关线程,从而兼顾异常覆盖和数据压缩。整体架构如图4示。
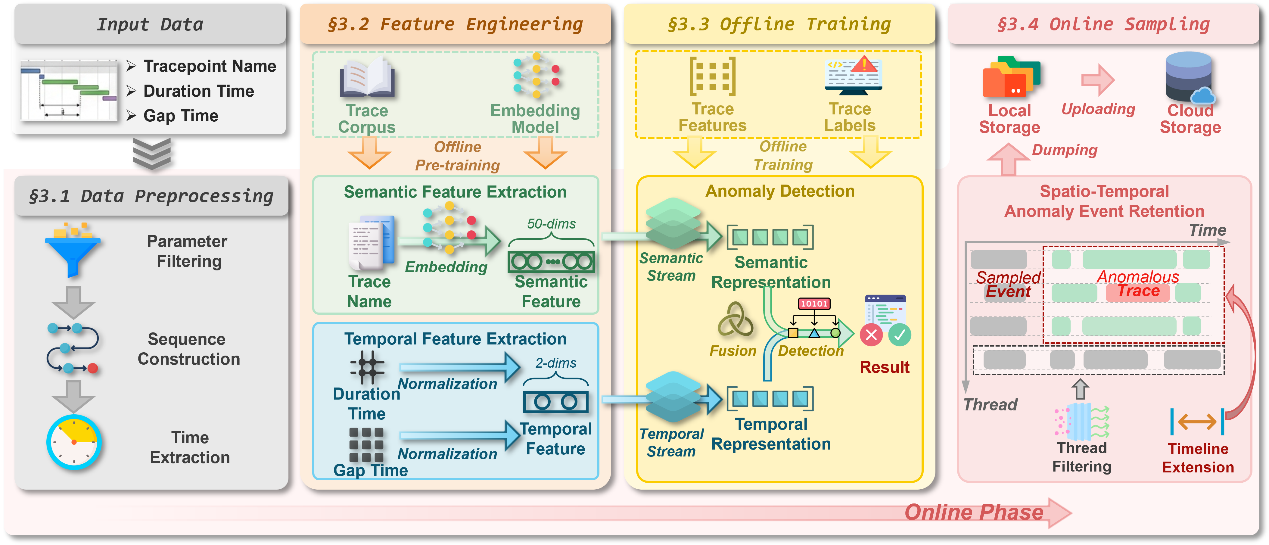
图4:CoreCapture整体框架
其中,双流系统调用链异常检测模型(DS-TraceNet)通过双支路网络架构,语义支路采用FastText子词提取操作的语义信息,时间支路学习事件中系统调用链的持续时间与间隔时间特征,这种设计避免高维语义特征掩盖时间信号,使模型同时识别操作模式变化与执行延迟异常。随后时空异常事件保留机制(STA-ER)以异常锚点为中心,在时间维度扩展至完整的用户交互事件,保留异常发生前后的执行过程;在空间维度依据关键线程知识库筛除无关线程。最终,系统只将保留下来的事件窗口及关键线程数据持久化并上传云端,在减少平稳运行数据的同时,为后续性能分析和根因诊断提供必要的上下文。
Part.4实验验证与部署成效
研究基于三个主流应用在滑动与动效两类场景中的真实生产数据进行评估,共包含六种应用与场景组合、48个独立维护工单、43类异常、870个事件及661,480条系统调用链。 CoreCapture在调用链级的F1分别为0.800和0.751。在事件级异常召回率分别为0.947和0.964,平均数据保留比例分别为0.277和0.358。
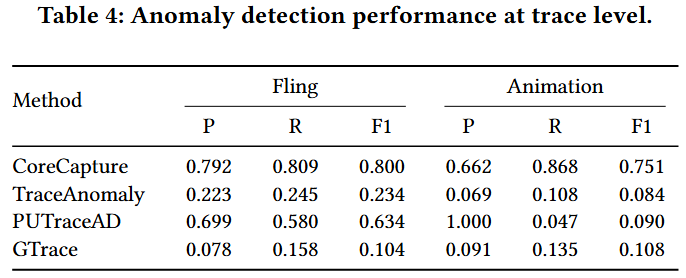
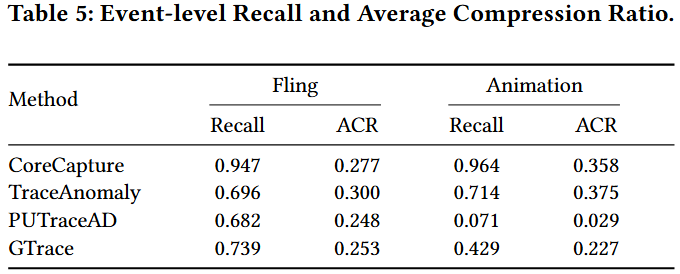
与三种基线方法相比,其同时保持较高的异常覆盖率和较高的数据压缩量。
CoreCapture已在内部测试设备上部署实测,显示在每次告警处理期间增加约4%-5%的CPU开销与13-15 MB内存开销,单次耗电约0.11 mAh,最终转储数据量缩减约70%。
Part.5研究意义与展望
CoreCapture解决移动设备性能诊断中的关键问题,“如何在有限资源下保存可供诊断的异常现场”,在资源受限的移动设备上兼顾较高异常事件覆盖率与较低转储数据量。研究提出异常感知调用链采样任务,并通过联合识别操作语义与时间异常、保留完整交互事件及关键线程,在减少约70%采集数据的同时,保留约95%的异常事件。这使共享的上传额度能够支持更多次调用链采集,也为云端分析性能瓶颈和定位根因提供了必要的上下文。
论文公开了源代码演示及两个数据案例,为后续端侧智能诊断研究提供参考。未来,可进一步研究不同设备、应用和性能问题下的采样策略,并探索系统更新后调用点变化及关键线程知识变化对长期运行效果的影响,持续提升端侧采样的适应性与诊断价值。

 津南校区地址:天津市津南区海河教育园同砚路38号
 邮编:300350